我最近在自己的機器上架了一個 Base Mainnet RPC。
一開始的需求其實很單純。我正在做一些把 AI 接進鏈上資料探索的實驗:讓 Agent 可以自己讀取池子狀態、批次模擬合約呼叫、比較不同區塊的結果,再把資料整理成可以繼續研究的上下文。公共 RPC 當然也能做,但只要查詢開始變密、方法開始變特殊,限流、延遲、歷史範圍和供應商支援就會很快變成新的限制。
所以我想自己掌握一個 RPC。理由很務實:資料來源、模擬方式,以及之後要加的工具,我希望都能自己控制。
真正開始做之後,我才發現最難的部分根本不是 docker compose up。
第一個坑:官方寫 782 GB,不代表你準備 1 TB 就夠了
Base 官方現在提供 Snapshot,Minimal 只包含 state 和 headers,頁面標示大約 782 GB;Full 則接近 918 GB。看起來如果手上有一顆 2 TB NVMe,跑一個剪枝過的節點似乎很寬裕。
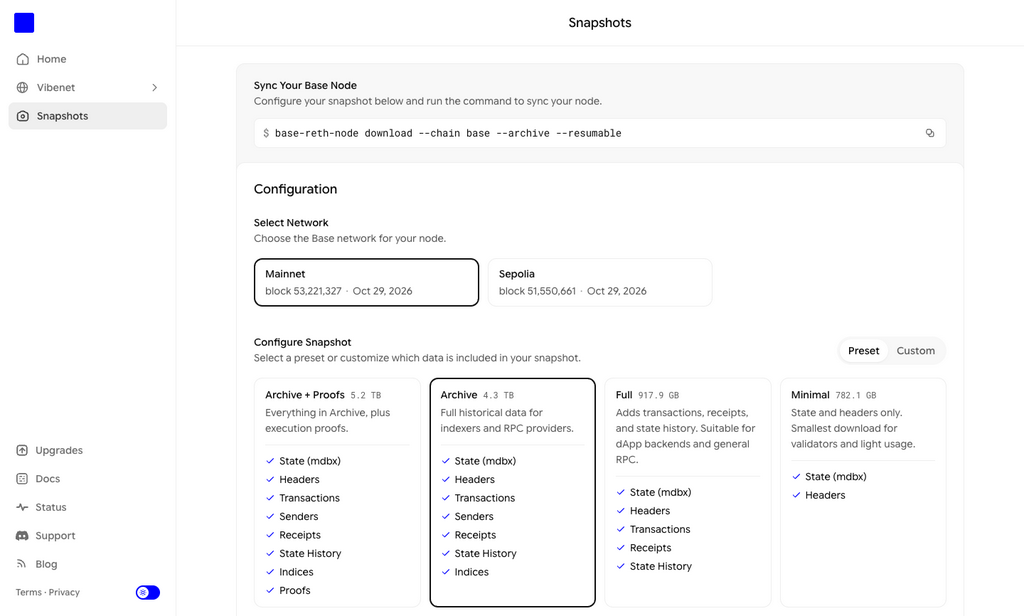
圖:Base 官方 Snapshot 頁面。Minimal 是最小的下載方案,但「下載大小」不是最後真正會占掉的所有磁碟空間。
但官方另外一份 Node Performance 文件,對容量的建議其實保守很多:需要把目前 chain size、snapshot restore 過程和額外 buffer 一起算進去。這不是多餘的保險。我實際跑下去之後,manifest 對應的 state 壓縮資料大約 731 GB,解壓後輸出接近 1.1 TB。最後節點同步完成後,我的 reth-data 目錄已經大約 1.2 TB,整個資料碟使用量則超過 1.38 TB。
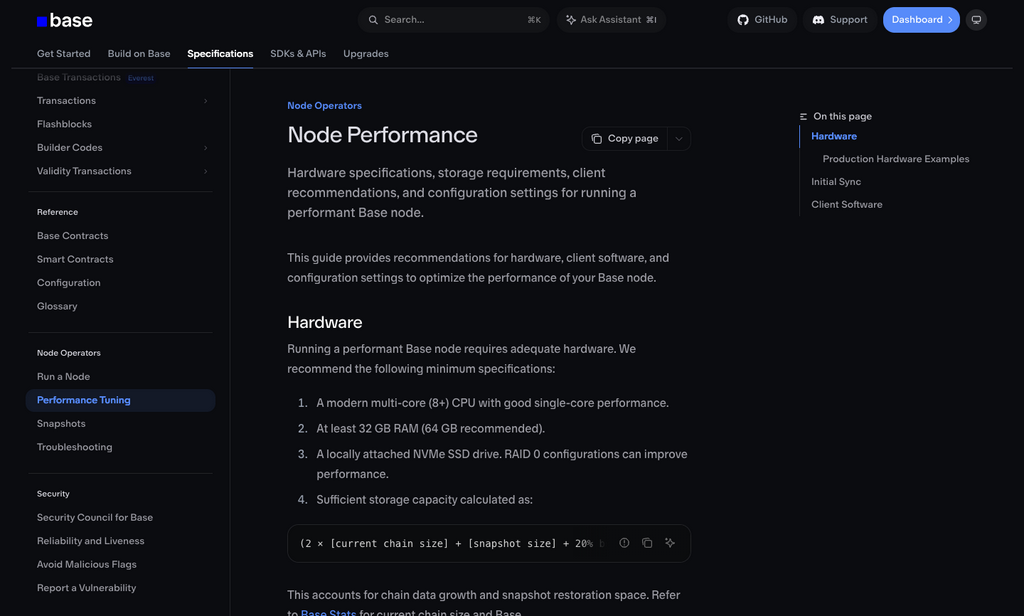
圖:Base 官方 Node Performance 文件。真正容易低估的是 snapshot restore 與後續 chain growth 所需的額外空間。
這是我第一個認知修正:Snapshot 頁面上的數字比較像「你要搬多少資料過來」,不是「你的節點最後只會用多少空間」。
如果只是照下載容量買硬碟,很容易在最糟糕的時候才發現空間不夠——資料已經下載幾百 GB、解壓也跑了一大段,然後才被迫重來。
第二個坑:我原本以為關掉 resumable,就不會再吃一份巨大 cache
我選的是 Base 官方 base/base 節點映像,執行層使用 Base Reth,另外跑 Base consensus。因為這個 RPC 主要拿來做現在狀態與近期資料探索,我沒有做 Archive Node,而是把多個資料類型設成保留最近 50,000 blocks。
這裡有一個很實際的需求:我希望 RPC 能用 Reth 原生的 eth_callMany。
它不是 JSON-RPC batch,也不是 Multicall 合約。它可以把一組模擬呼叫放在同一個 bundle 裡順序執行,後面的 call 可以看到前面 call 改變過的模擬狀態,但整個過程不會真的上鏈。對 AI Agent 來說,這比單純一次一次 eth_call 更有意思,因為 Agent 可以把一串假設當成一個小型實驗來跑。
節點本身的 Compose 其實很簡單:execution 對 localhost 開 8545/8546,consensus 另外跑一個服務,P2P port 對外。真正拖時間的是 snapshot restore。
我一開始直接用 Reth 內建的 snapshot downloader,還特別測試過 --resumable=false,以為可以避免把完整壓縮檔留在磁碟上。結果實際跑起來,這個版本在 manifest 路徑和 single-archive 路徑都還是會建立一個大約 709 GB 的 sparse cache。
對一台磁碟空間本來就抓得很緊的機器來說,這件事很致命。你已經要放一份解壓後超過 1 TB 的資料庫,如果下載器旁邊又同時保留七百多 GB cache,2 TB NVMe 很快就沒有操作空間了。
所以最後我沒有繼續跟 downloader 的參數硬拗,而是換掉下載方式。
我最後自己做了 Range streaming:每次只承擔 64 MiB 的失敗。
我寫了一個很小的 range streamer,把 snapshot 拆成固定大小的 HTTP Range。現在預設每段 64 MiB,每一段完整收到之後才送進 zstd,再直接 pipe 給 tar 解到 Reth 的資料目錄。
概念上變成:
HTTP Range (64 MiB)
        ↓
      zstd
        ↓
       tar
        ↓
/data/db這個改法沒有神奇地讓下載變快,真正改變的是一次失敗會損失多少進度。
我中間真的遇過 HTTP/2 連線中斷。如果是一條從頭串到底的大下載,斷線位置可能已經在數百 GB 之後;改成 Range 之後,網路失敗只需要重抓當下那 64 MiB。程式會對該 range 自動 retry,再繼續下一段。
這個方案仍然不是完美的「跨程序續傳」。如果整個下載程序或主機停止,正在串流解壓的資料庫不能保證可直接接著用,我還是會清掉不完整的 DB state 後重跑。但至少一般網路抖動不再等於七百 GB 重來。
我另外加了一個磁碟 watchdog,每五秒檢查一次資料碟。如果可用空間低於 150 GiB,就直接停止 snapshot 流程。下載與 execution 也做成互斥,避免節點正在打開資料庫時又有另一個 restore 流程進去改同一份資料。
這些東西都不是「如何跑 Base Node」文件裡最顯眼的部分,卻是我最後覺得最重要的工程工作:不要只設計成功路徑,要先決定 700 GB 之後失敗時你準備怎麼收場。
Memory 調教不是設一個數字,而是控制每一個 stage 吃多少資料
這台機器有 64 GB RAM,所以我沒有把 Reth 當成「記憶體越大越好」來跑。真正有用的調整,是限制不同同步階段一次可以緩衝和處理多少資料,讓記憶體、SSD I/O 與同步速度之間不要互相拖垮。
例如目前的 Reth 設定裡,Bodies downloader 的 buffered blocks 上限約 2 GiB;Execution、Account Hashing、Storage Hashing 都有各自的 block / changes / commit threshold;ETL file size 也固定在約 500 MiB。這些參數不等於「Reth 最多只能用多少 RAM」,但會直接影響一個 stage 一次累積多少工作、多久寫回資料庫,以及 SSD 會承受多大的瞬間壓力。
我實際調整時比較在意的不是把 RAM 塞滿,而是讓 Execution 與 MerkleExecute 可以持續往前。batch 太大,可能暫時看起來吞吐很高,卻把 random I/O 和 commit 壓力集中到 SSD;batch 太小,又會增加切換與 commit 成本。這台機器最後採用的是偏保守的做法:保留足夠 page cache 給 Linux 和 MDBX,讓 Reth 有空間吸收讀取,同時避免某個同步 stage 一口氣把所有資源吃掉。
節點跑起來,不代表 RPC 已經可以相信
Snapshot restore 完成後,下一個坑是「看起來有回應」很容易讓人太早宣布成功。
eth_chainId 回 8453,不代表已經跟上 Base Mainnet;eth_syncing 某一刻回 false,也不能單獨證明你拿到的是最新狀態。我的節點在追趕過程中曾經落後 500 多個 blocks,RPC 一樣可以正常回答很多查詢。如果這時拿它去做即時市場判斷,答案只是很完整地描述過去。
所以我最後又寫了一支 status.py,同時看幾件事:
- execution / consensus 容器有沒有正常跑
- chain ID 是否為 8453
- latest / safe / finalized 高度
- latest block timestamp 距離現在多久
eth_syncing與 peer 數量- 本機高度和外部 Base RPC 的 block gap
- 資料碟剩餘空間
我後來也發現,只看某一刻的 block gap 很容易判斷錯。節點有時可以追到只差十幾個 blocks,幾分鐘後又重新拉開;eth_syncing 甚至可能已經回 false,但 RPC head 還沒有穩定貼住最新鏈頭。
進一步看 Reth 的 stage 日誌後,原因就比較清楚了。它不只是單純「來不及處理新區塊」,而是在重啟後繼續補做前面尚未完成的同步工作:先跑一段 Execution,再進入 MerkleExecute 計算對應區塊的 state root,完成這一輪 pipeline 後 RPC head 才會繼續往前。某次觀察裡,MerkleExecute 從 53,228,153 推進到 53,228,198,大約用了 14 秒;接著 Execution 從 53,228,199 跑到 53,228,280,約 119 秒,之後又回到 Merkle 階段。與此同時,新區塊仍持續被節點接收。
這個差別很重要。表面上看都是「落後幾十個 blocks」,但背後可能不是節點完全卡死,也不一定代表 SSD 單純無法跟上 Base 的即時出塊速度;它可能正在消化歷史 pipeline backlog。當時 MerkleExecute 階段 NVMe utilization 一度到約 97%,主要是大量 4 KB 隨機讀取,所以儲存 I/O 仍然是需要觀察的瓶頸,但我不會因為看到一次高 utilization 就立刻換 SSD。更合理的判斷方式,是看 stage checkpoint 是否持續前進、每分鐘實際處理多少 blocks,以及長時間下來 block gap 是縮小還是擴大。
這也改變了我看 RPC 健康度的方式。我不再只問 endpoint「能不能連」或 eth_syncing 是否為 false,而是把它當成一個需要持續量測新鮮度與同步進度的資料源。對一般鏈上資料探索,只要狀態足夠新而且延遲可接受,它仍然有價值;如果目標是極低延遲套利,就必須用更嚴格的標準看 block age、gap 與 pipeline 是否穩定貼住鏈頭。
落後一個 block 的 RPC,還有沒有價值?
有,而且對我的用途來說仍然很有價值。
這台 RPC 主要不是拿來做最後一毫秒的送單決策,而是拿來追蹤 DEX 鏈上狀態,配合 AI 做合約 eth_call / eth_callMany 分析。Agent 可以讀池子狀態、token balance、合約 storage 與 route 資訊,再根據前一輪結果決定下一輪要模擬什麼。
在這種工作裡,落後 1 個 block 和落後幾十、幾百個 blocks 是完全不同的問題。只差 1 個 block 時,絕大多數合約結構、池子組成、route 關係、token metadata,以及大量不會每個 block 都改變的 state 仍然可以拿來做探索、篩選與候選分析。它也很適合用來做大量讀取與模擬,避免所有研究型查詢都壓到外部 RPC。
但如果要把分析結果轉成真正的即時交易,最後一步仍然必須重新確認最新 block。DEX 的 reserve、tick、liquidity、nonce 或其他會直接影響交易結果的狀態,差一個 block 就可能已經不同。我的做法會把本地 RPC 當成研究與模擬層:先用它大量探索、建立候選,再在需要即時性的最後一步用最新狀態重新驗證。
所以我現在追蹤 block gap,不是因為 gap 只要不等於 0,整台 RPC 就失去價值。真正要判斷的是:它現在適不適合這個工作。 對 DEX 資料探索與 AI 合約分析,落後 0~1 個 block 通常仍然很有用;如果 gap 開始持續擴大,或 block age 拉到數十秒、數分鐘,我才會把它視為同步品質問題,而不是單純的瞬間差距。
這台 Base RPC 對我來說,就是一個可控的鏈上研究資料源。DEX 追蹤程式先把鏈上的變化抓回來,AI 再透過 eth_call、eth_callMany 和合約狀態做進一步分析。它不需要承擔所有事情,但只要我知道它現在有多新、同步 pipeline 正在做什麼,它就能成為很實用的一層基礎設施。