我一開始測 Qwen-Image-2.1 時,其實把重點放錯了。
最早我注意到的是提示詞理解、畫面組織與原生 2K。這些當然都有進步,但看完官方這次完整展示後,我重新在自己的機器上跑了一輪,才發現 2.1 真正值得注意的地方,不只是「更會把文字變成圖片」,而是它把生成與編輯放進了同一套模型裡。
所以這篇也重新來過。
這次不只放幾張 text-to-image 成品,而是直接在我的 RTX 5060 Ti 16GB 上測:
- 圈選區域後只改局部
- 同時參考兩張圖片再重新組合
- 把上一張輸出繼續餵回去,做連續畫面
- 直接生成有 alpha channel 的透明 PNG
- 從一般 RGB 照片抽出透明人物圖層
- 用同一角色做三格 Storyboard
- 直接輸出 2048×2048,順便測文字排版
測完之後,我對 Qwen-Image-2.1 的定位已經和第一次完全不同:它比較像一個本地視覺創作與編輯模型,而不只是生圖模型。
這次的本地測試環境
所有下面標示為「實測」的圖片,都不是 Qwen 官方 showcase,也不是雲端 API,而是我自己的機器生成。
- GPU:NVIDIA GeForce RTX 5060 Ti 16GB
- RAM:64GB
- ComfyUI:0.37.0
- Diffusion model:
qwen_image_2.1_int8_convrot.safetensors - Text encoder:
qwen3vl_8b_int8_convrot.safetensors - VAE:
qwen_image_2.1_vae_bf16.safetensors - 一般測試:1024×1024、25 steps、Euler、CFG 1
- 2K 測試:2048×2048、25 steps、Euler、CFG 1
這組配置對我來說很重要,因為它不是在 H100 或 5090 上證明「理論上可以跑」,而是我平常就在用的 16GB 消費級顯卡。
先講結論:這次的核心不是 T2I,而是 unified creation + editing
Qwen 官方把 2.1 定義成一個統一的 text-to-image 與 image editing 模型。它的視覺生成部分是 7B,文字與參考圖片則交給 Qwen3-VL 8B 編碼。
真正改變使用方式的是:同一套模型既可以從零生成,也可以把圖片餵回去繼續改。
這和「先用一個模型生圖,再換另一個 inpaint / edit model」的感覺不太一樣。至少在我現在的 ComfyUI workflow 裡,生成、參考圖、局部修改與連續修改可以沿用同一個 Qwen-Image-2.1 流程。
官方資料:
實測一:畫一個紅圈,真的只改圈裡的東西
這個測試是我覺得最能說明 2.1 差異的一個。
我先拿前一輪生成的白貓圖片,在左側耳罩外面直接畫一個紅圈,然後要求:
只把紅圈內的左側耳罩改成亮黃色,最後移除紅圈;貓臉、眼睛、毛、另一側耳罩、背景、燈光與構圖都保持不變。
結果如下,左邊是帶紅圈的輸入,右邊是輸出:
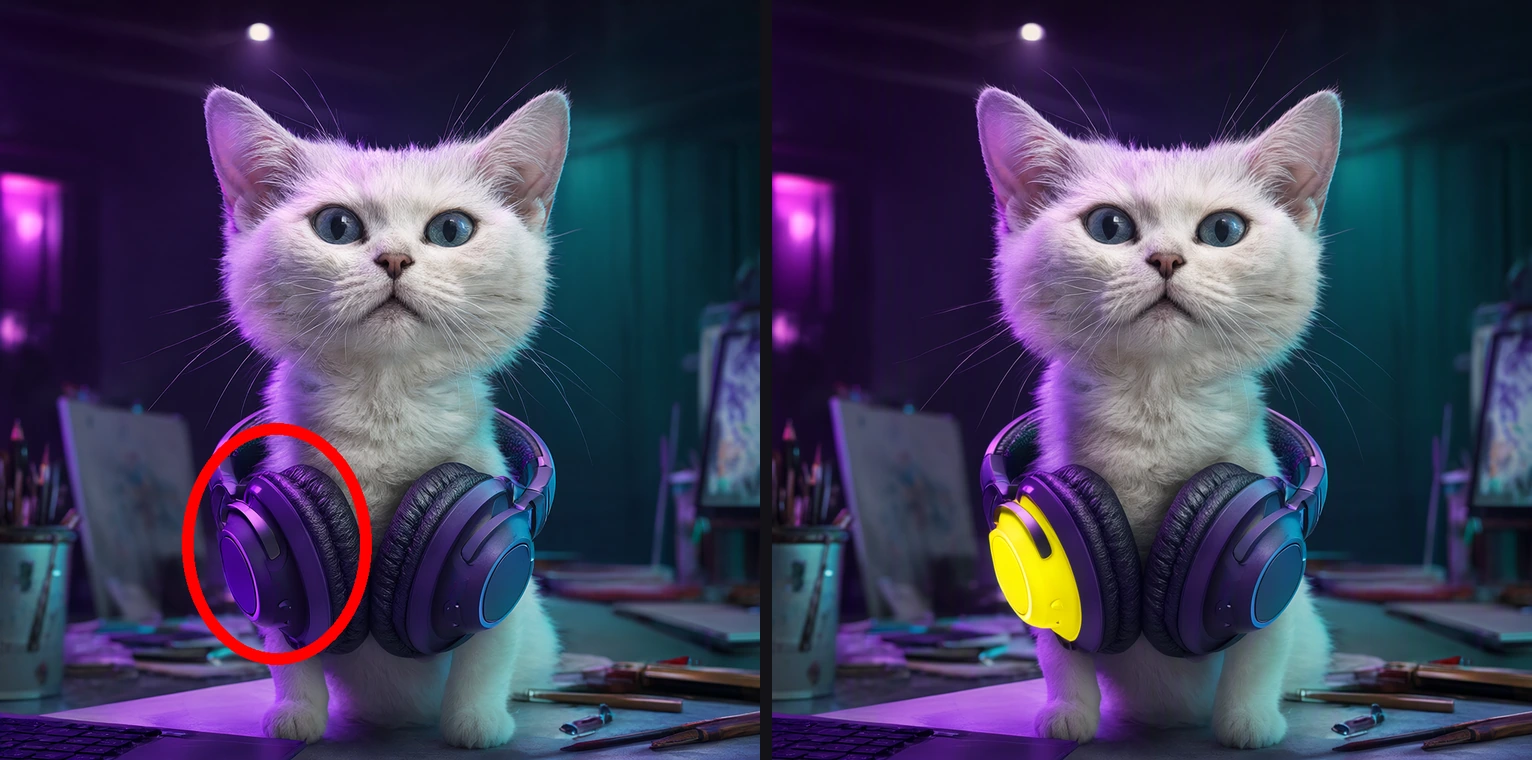
這次結果相當乾淨。
紅圈沒有被留在成品裡,圈內耳罩從紫色變成黃色,而貓臉、另一邊耳罩、工作室背景與整體構圖幾乎沒有被重做。
這讓「局部修改」變得很直覺:不一定要先精準畫遮罩,也可以直接用視覺標記告訴模型「改這裡」。官方還展示了 painted annotation 與獨立 mask;這篇我實際驗證的是 circle-guided editing,沒有把另外兩種也假裝成已測過。
實測二:兩張 reference,不只是風格參考,而是真的重新組合
接著我把兩張完全不同的本地圖片一起送進去:
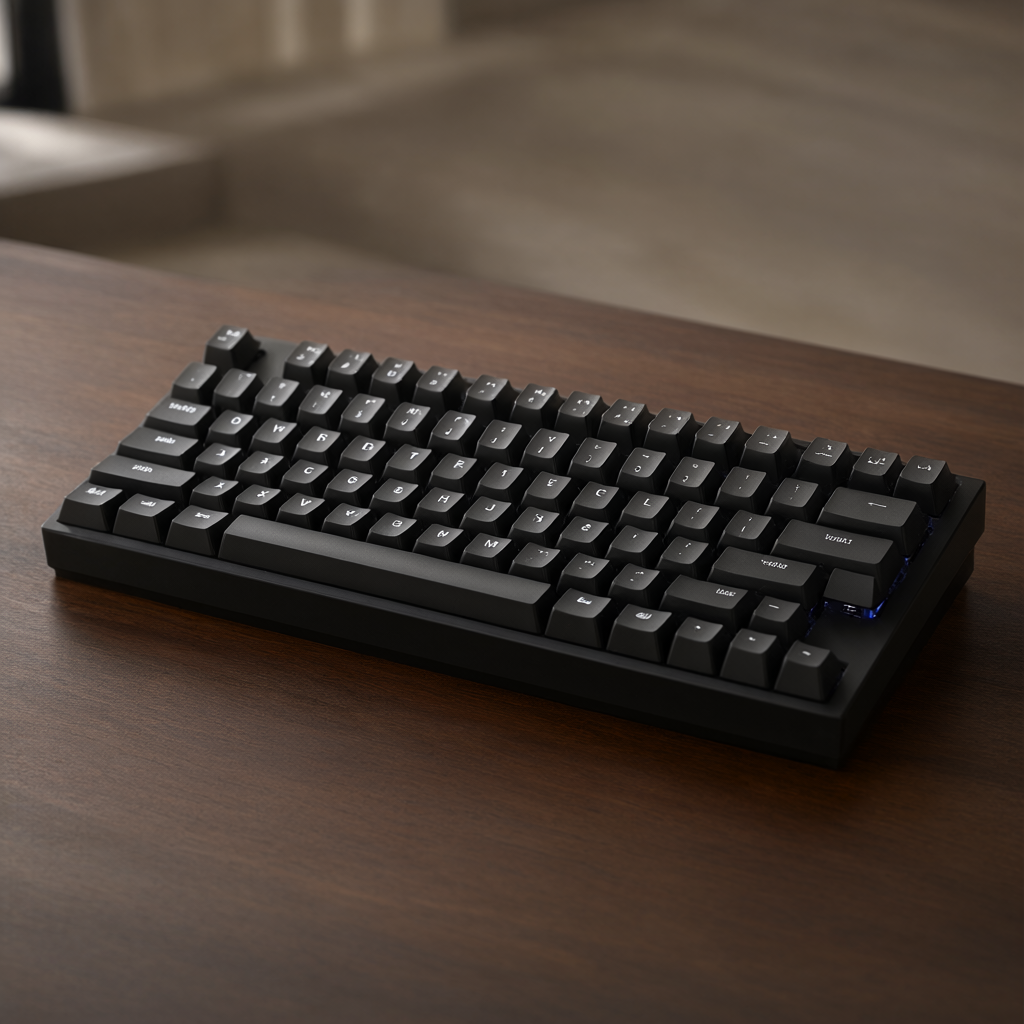
- 白貓 + 紫色耳機
- 黑色機械鍵盤
要求模型把同一隻貓放到鍵盤後方,保留白貓的臉、耳機,以及鍵盤的黑色外型與 keycap 特徵。
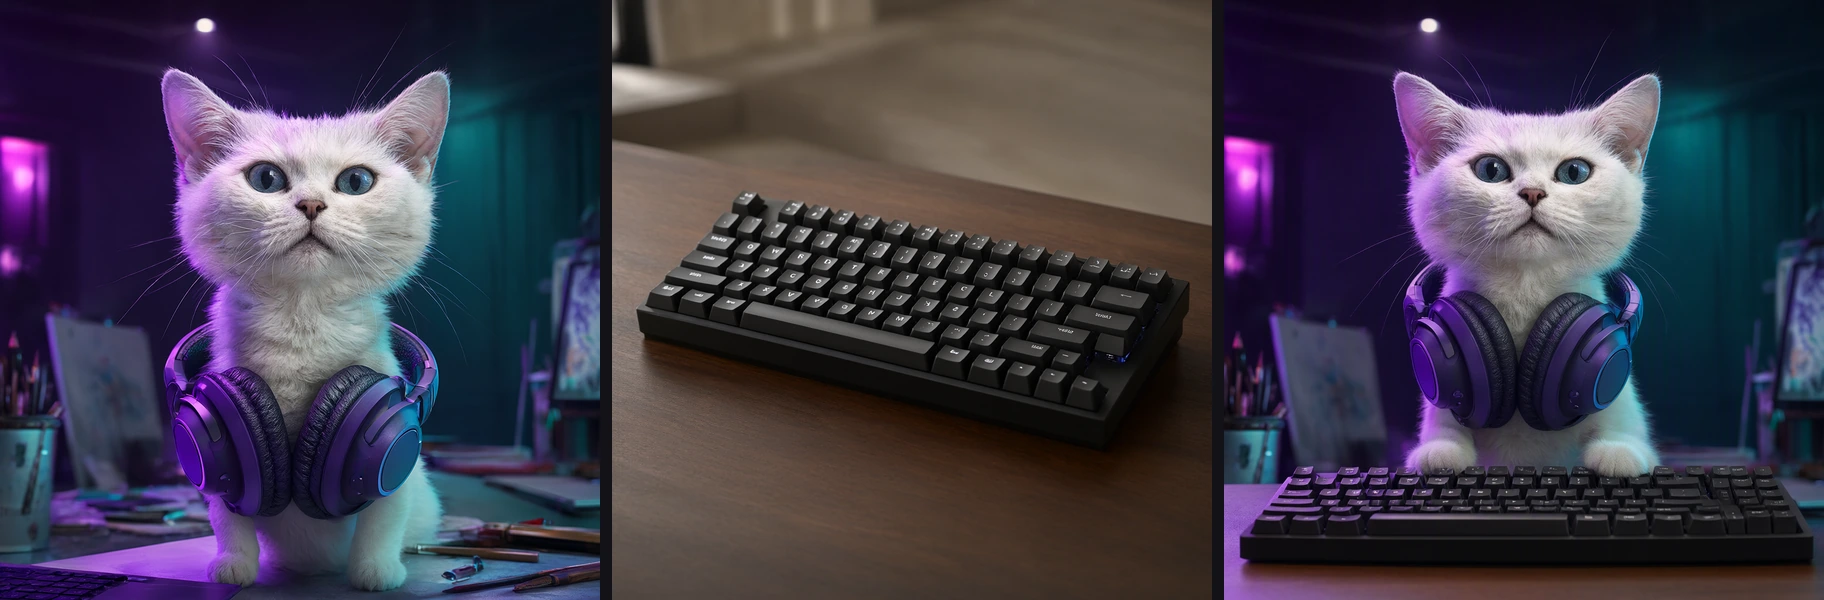
結果不是把其中一張當 style reference 而已,而是真的把兩個來源重新放進同一個場景。
白貓的臉、白毛與紫色耳機延續得很明顯;鍵盤也保留了黑色機械鍵盤的外型,並被重新安排到前景。
當然,這不代表 reference fidelity 已經等同於 3D asset compositing。鍵帽細節和原圖不是 pixel-perfect 複製,細小字元也會重新生成。但就「把多個素材交給同一個模型,再請它組成一個合理的新畫面」這件事而言,已經是不同層級的工作方式。
官方宣稱最多可輸入 10 張 reference images。我目前實際測的是 2 張,因此我可以確認兩張在這台機器上正常工作,但不會把「最多 10 張」寫成本機已逐張壓測過。
實測三:同一張圖連續改三次,可以做出動作序列,但會累積 drift
既然 image editing 能保留原圖,那下一個問題自然是:能不能把上一張結果繼續餵回去?
我用剛才的「貓 + 鍵盤」結果當 frame 0,連續做三次修改:
- 抬起一隻前爪
- 把抬起的爪子放到鍵盤上按鍵
- 低頭看鍵盤,兩隻前爪一起打字
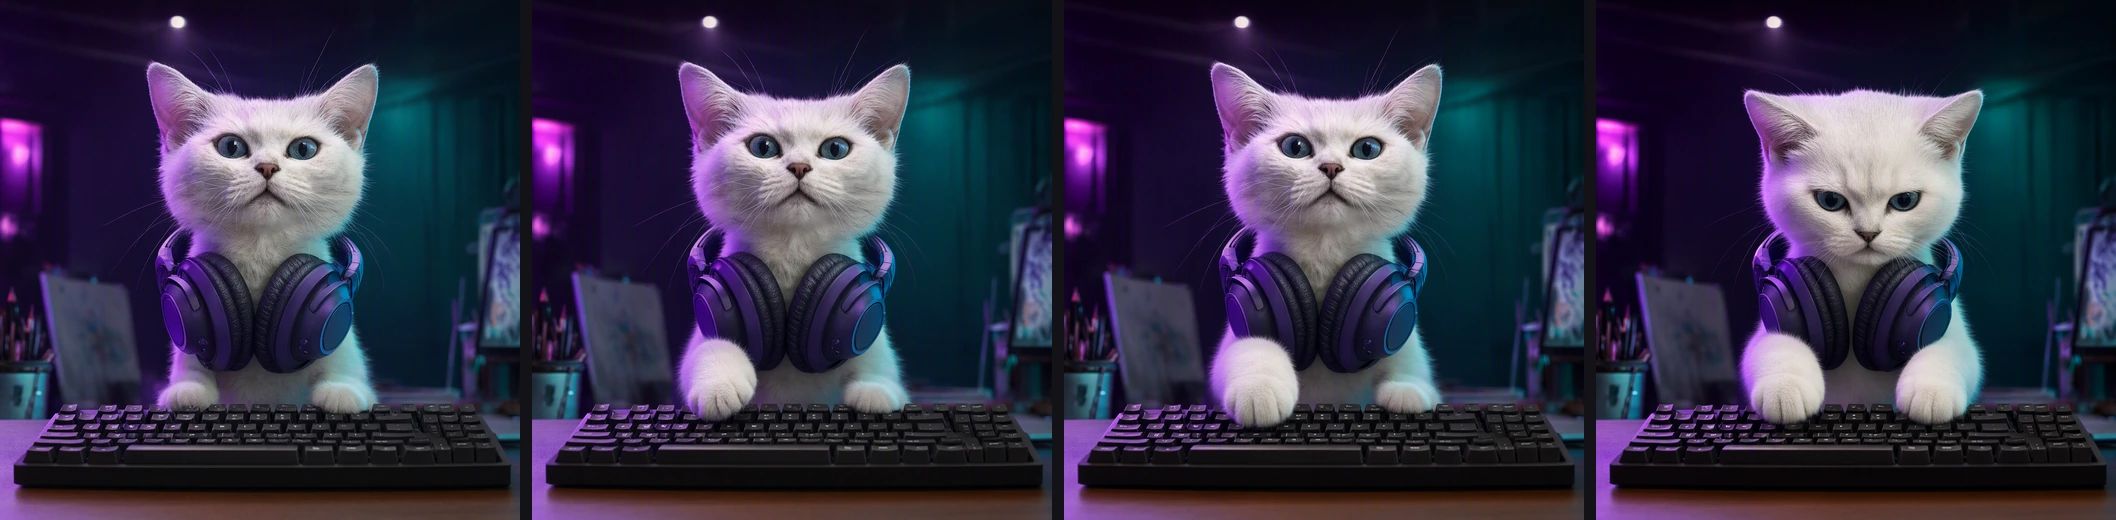
這個結果很有意思,因為它同時告訴我「可以」和「還不能太樂觀」。
前兩次 edit 的角色、耳機、鍵盤、鏡頭和背景延續性都很好,動作也確實按照要求變化。但到第三次繼續編輯時,雖然還是一眼看得出是同一個角色設定,臉型、耳朵和幼態程度已經開始發生 drift。
也就是說,Qwen-Image-2.1 已經可以拿來做 sequence planning、分鏡草稿,甚至把幾張結果串起來做簡單動態;但如果要 20、50、100 幀都保持角色完全一致,我不會只靠這種「上一張接下一張」的方式。
這也是我覺得實測比官方 showcase 更有價值的地方:能力是真的,但誤差也會累積。
實測四:透明背景不是假棋盤格,PNG 真的有 alpha channel
Qwen-Image-2.1 另一個很不尋常的更新,是它的 VAE 原生支援 RGBA。
我直接照官方建議的 prompt 格式要求:
This is an RGBA image with transparency. A cute white cat mascot wearing purple over-ear headphones… The image has alpha channel and the background is transparent.
生成結果:
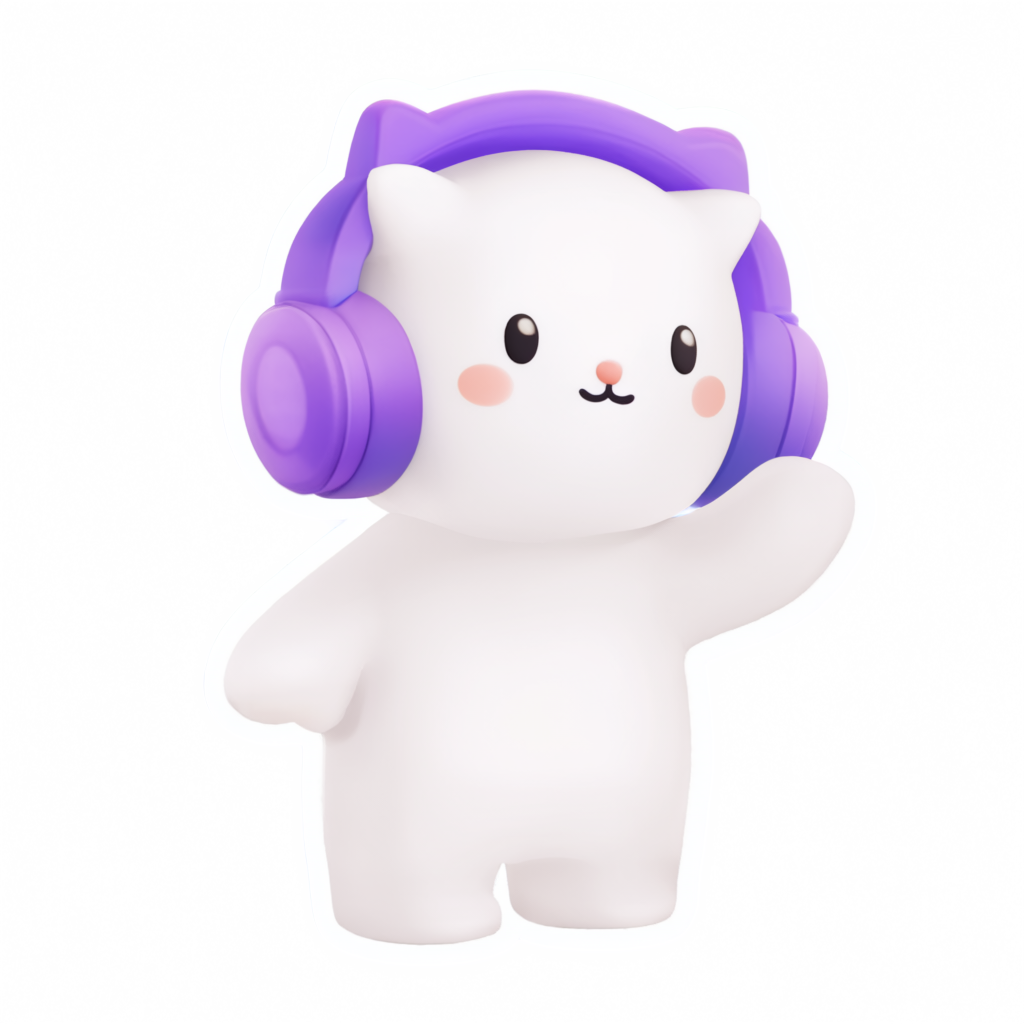
我另外直接讀 PNG 的 alpha channel,不靠肉眼判斷:
- alpha 範圍:0–255
- 完全透明像素:約 24%
- 半透明像素:約 39%
- 完全不透明像素:約 37%
所以這不是模型畫一張紫色/棋盤格背景來「看起來像透明」,檔案裡真的有透明度資料。
對做貼圖、角色素材、簡報元件、UI asset、商品合成的人來說,這件事很實際:少掉一個外部去背步驟。
實測五:一般照片可以直接抽成透明人物圖層
原生透明不只用在從零生成。
我把前一輪生成的人像照片重新餵回 Qwen-Image-2.1,要求保留人物的臉、頭髮、白色西裝、姿勢與完整輪廓,把整個攝影棚移除,輸出 RGBA。
結果:
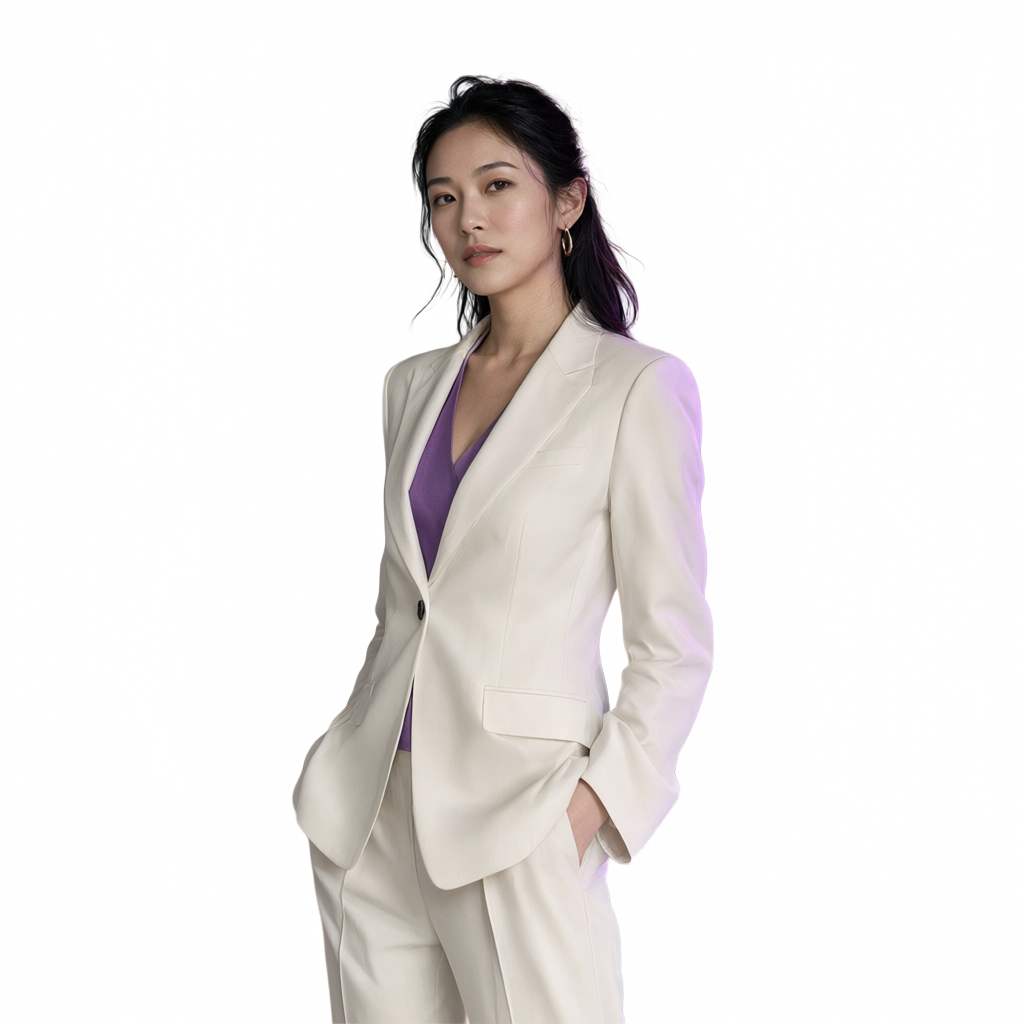
這張輸出的 alpha 也是實際存在:
- alpha 範圍:0–255
- 完全透明像素:約 37%
- 半透明像素:約 44%
人物五官、服裝和原本姿勢保留得相當完整,背景則被抽掉。
這個能力讓我對 2.1 的想法又再改一次:它不只是「AI 生一張透明 PNG」,而是開始碰到真正的 asset extraction / reusable layer 工作流。
實測六:同一角色直接生三格 Storyboard
官方 showcase 裡有一項是 storyboard。我沒有直接拿官方圖來轉述,而是用自己的白貓 reference 測一次。
我要求它在同一張圖片裡做三格:
- 貓走向鍵盤
- 貓抬起一隻爪
- 貓用兩隻爪打字
同時要求三格維持同一隻白貓、同一副紫色耳機、同一個工作室與相同色調。
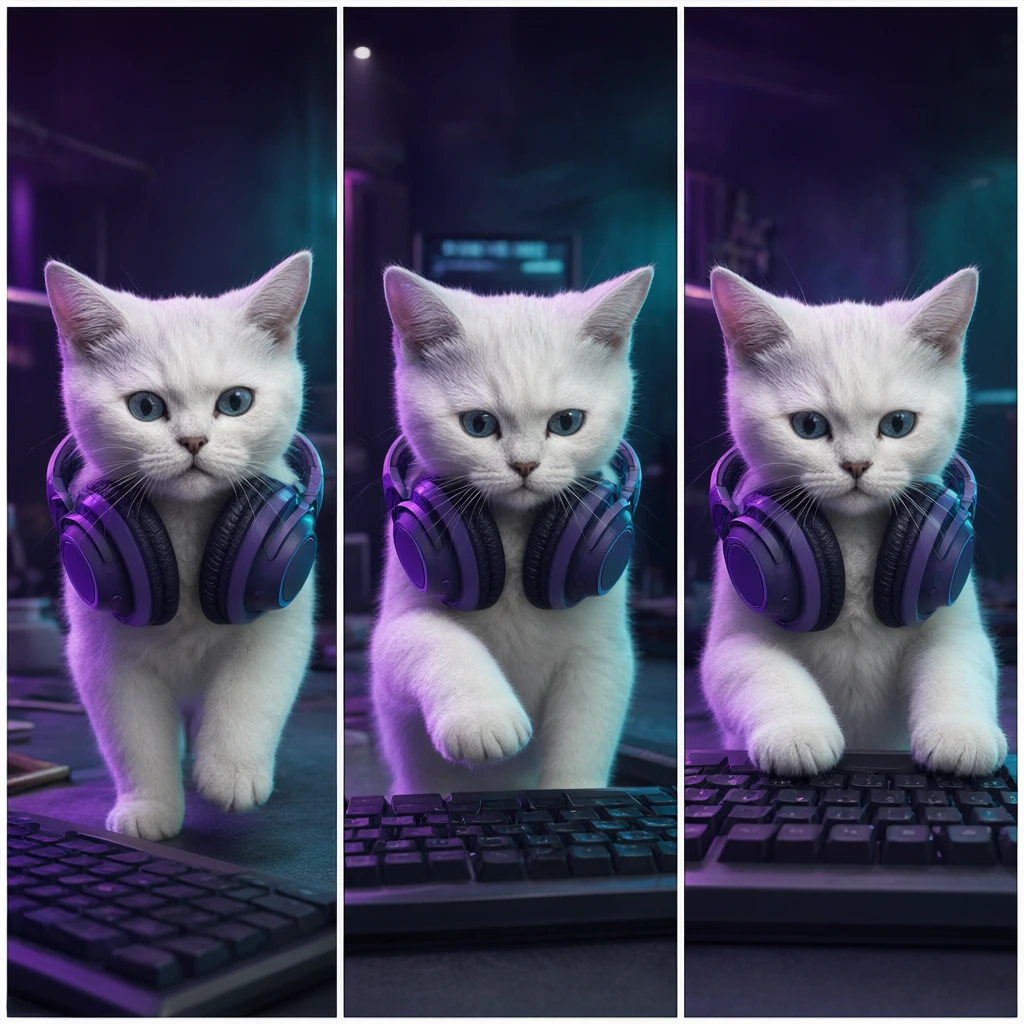
這次結果比我預期得好。
模型真的做出了三個清楚 panel,而且角色、耳機、紫/青色燈光都延續下來;三格動作也有前後關係,不是三張隨機貓圖硬排在一起。
它當然還不是動畫模型,但如果工作是廣告 shot planning、漫畫分鏡、短片 storyboard、角色概念提案,這種「一張 reference → 一組連續畫面」的用途已經很明確。
實測七:5060 Ti 16GB 真的能直接跑 2048×2048
我原本的文章只寫「官方支援原生 2K」,但實際展示的都是 1024×1024。這次乾脆自己跑。
我把 resolution 直接設成 2048,仍然使用 25 steps,並故意加一個文字排版要求:
- 大標必須是
QWEN IMAGE 2.1 - 副標必須是
LOCAL IMAGE CREATION - 中央是一隻戴紫色耳機的貓
結果如下,原始檔案就是 2048×2048:
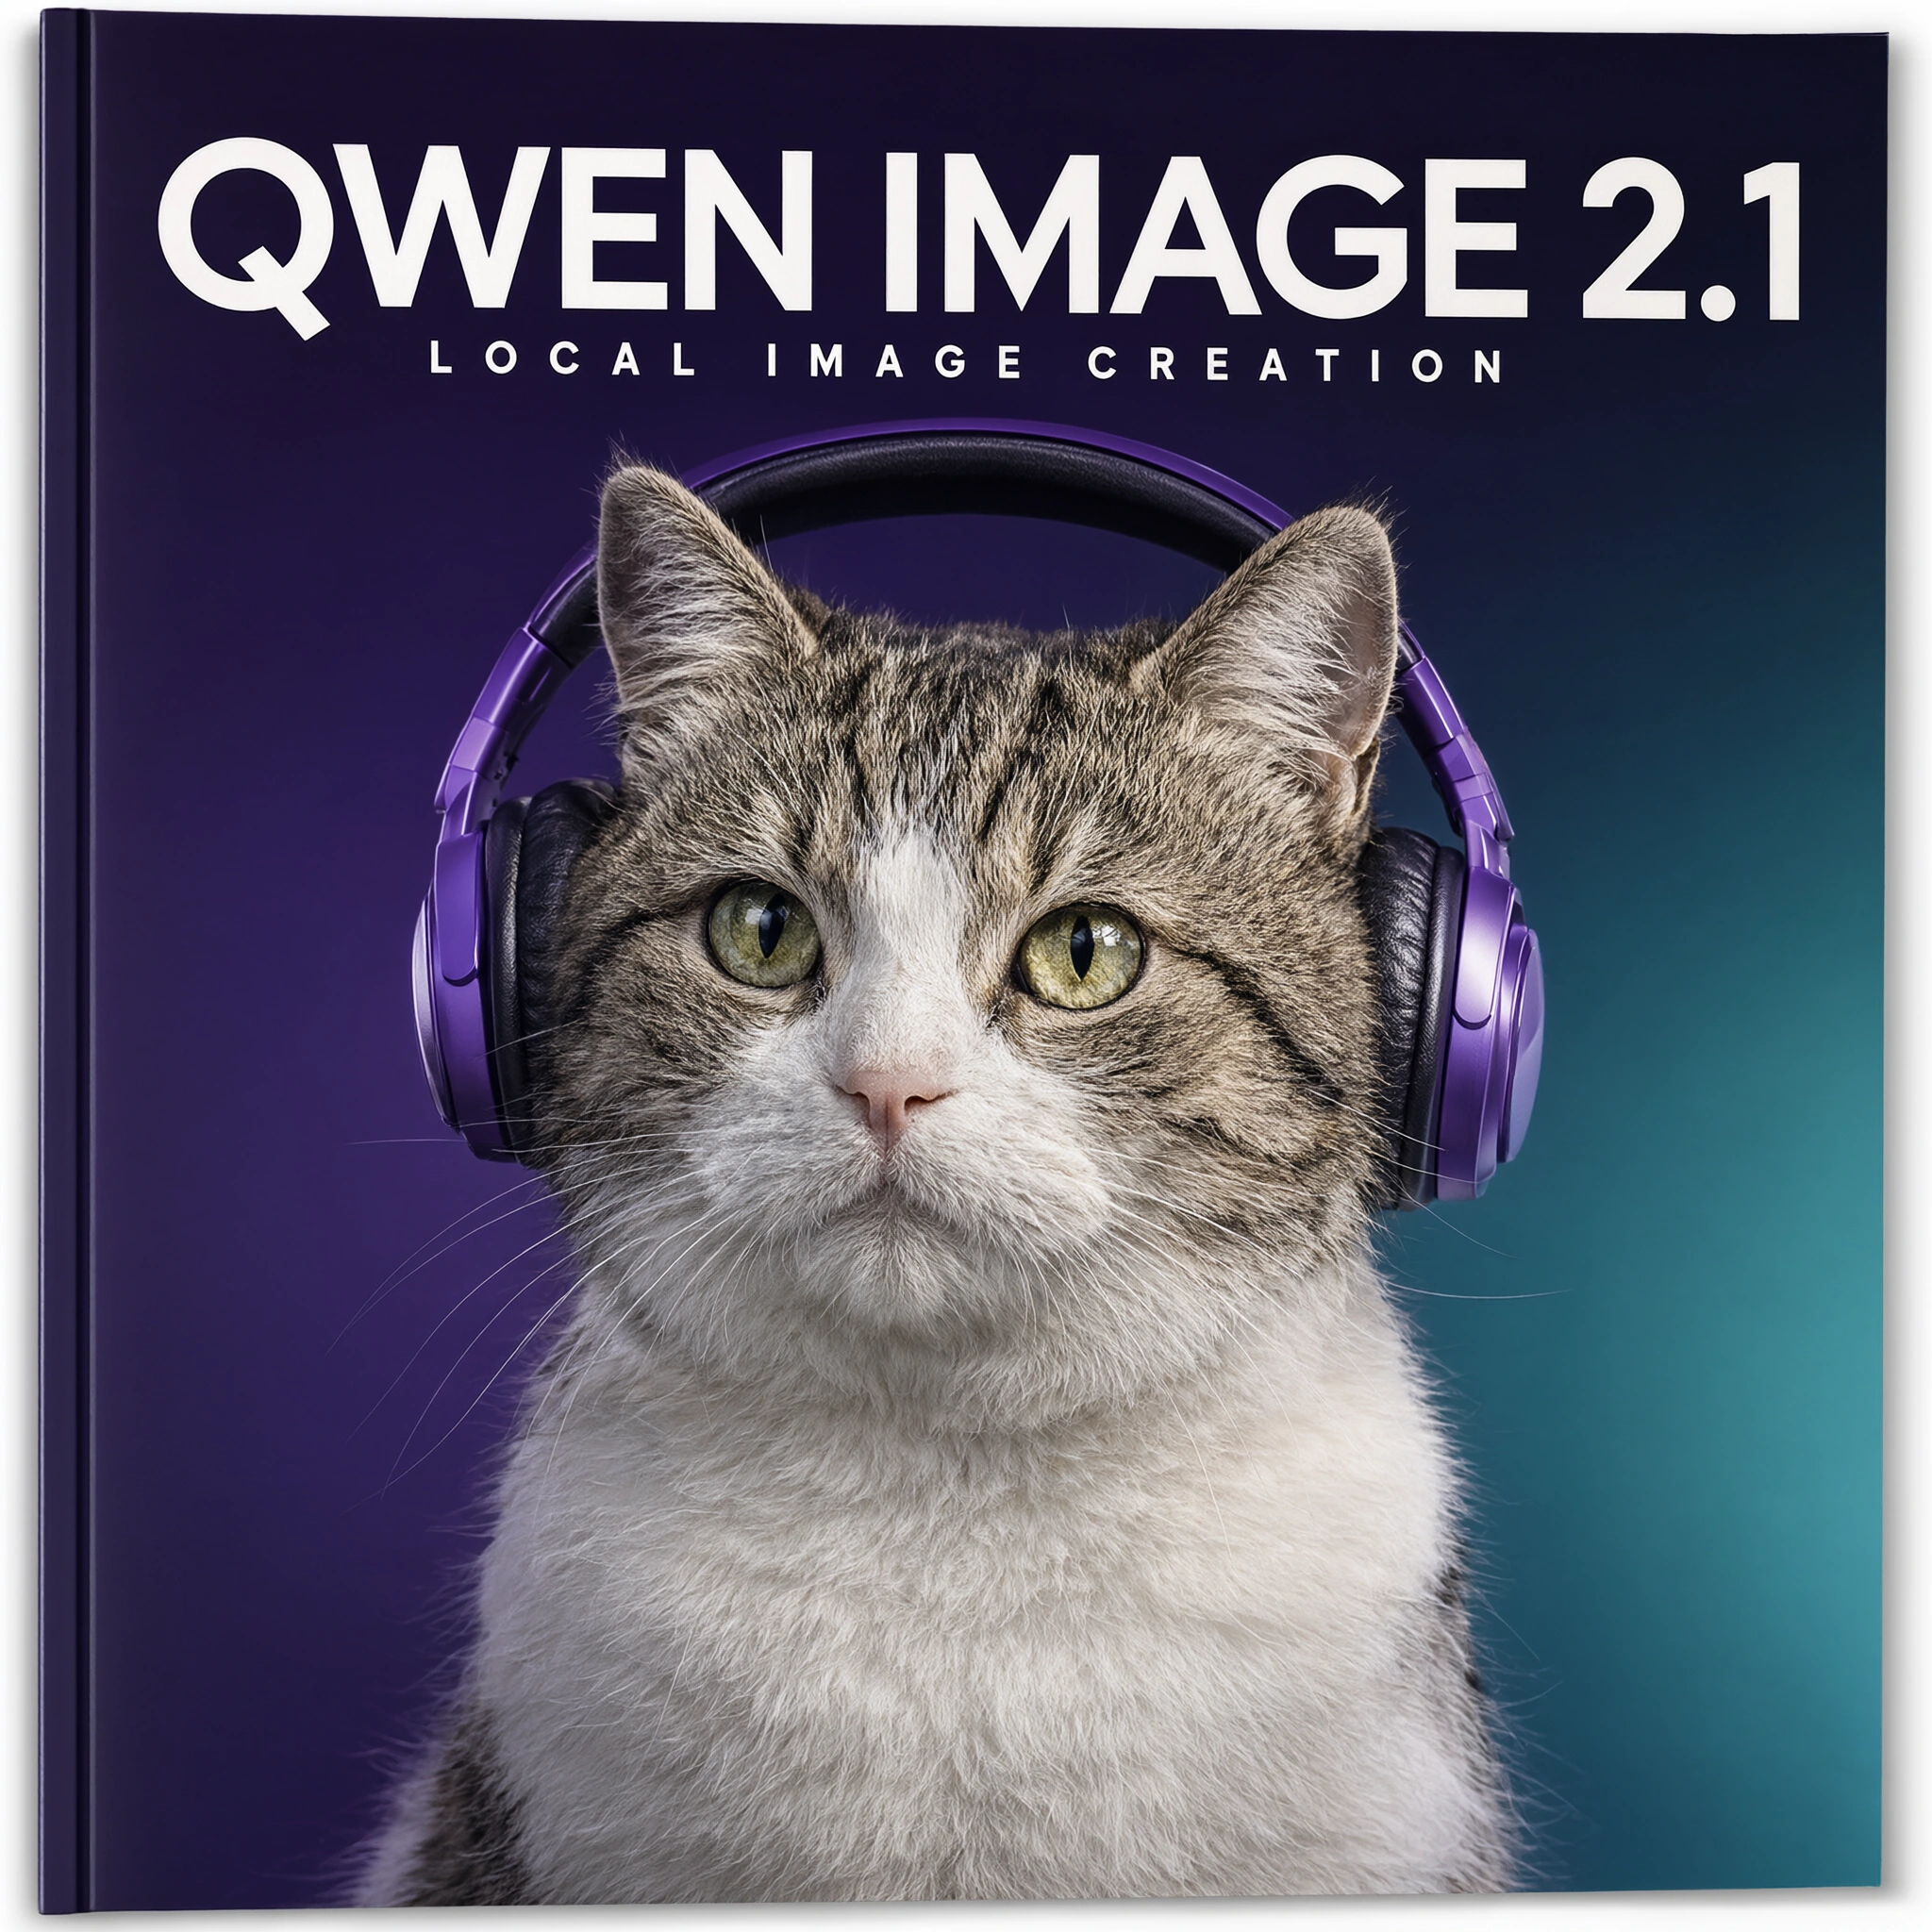
這次在我的 RTX 5060 Ti 16GB 上:
- 2048×2048 成功完成
- 25 steps 約 129 秒
- 執行時 GPU utilization 100%
- 觀察到的 VRAM 使用量約 15.5GB
文字表現也很值得注意:QWEN IMAGE 2.1 和 LOCAL IMAGE CREATION 都正確且可讀,排版不像早期生圖模型常見的亂碼。
但這張也不是完美答案。Prompt 要的是「white cat」,最後生成的貓明顯變成虎斑白貓。因此這張同時證明兩件事:2K 與英文文字排版很強,但 prompt 裡的每一個視覺屬性仍然不保證百分之百服從。
回頭看最基本的文字生圖,它反而只是 2.1 的起點
前一版文章裡,我用了幾張純文字生成圖,測產品攝影、台北雨後街景與人物攝影。
這些輸出本身沒有問題,而且仍然能看出 2.1 對完整場景描述、材質、光線與構圖關係的理解能力。
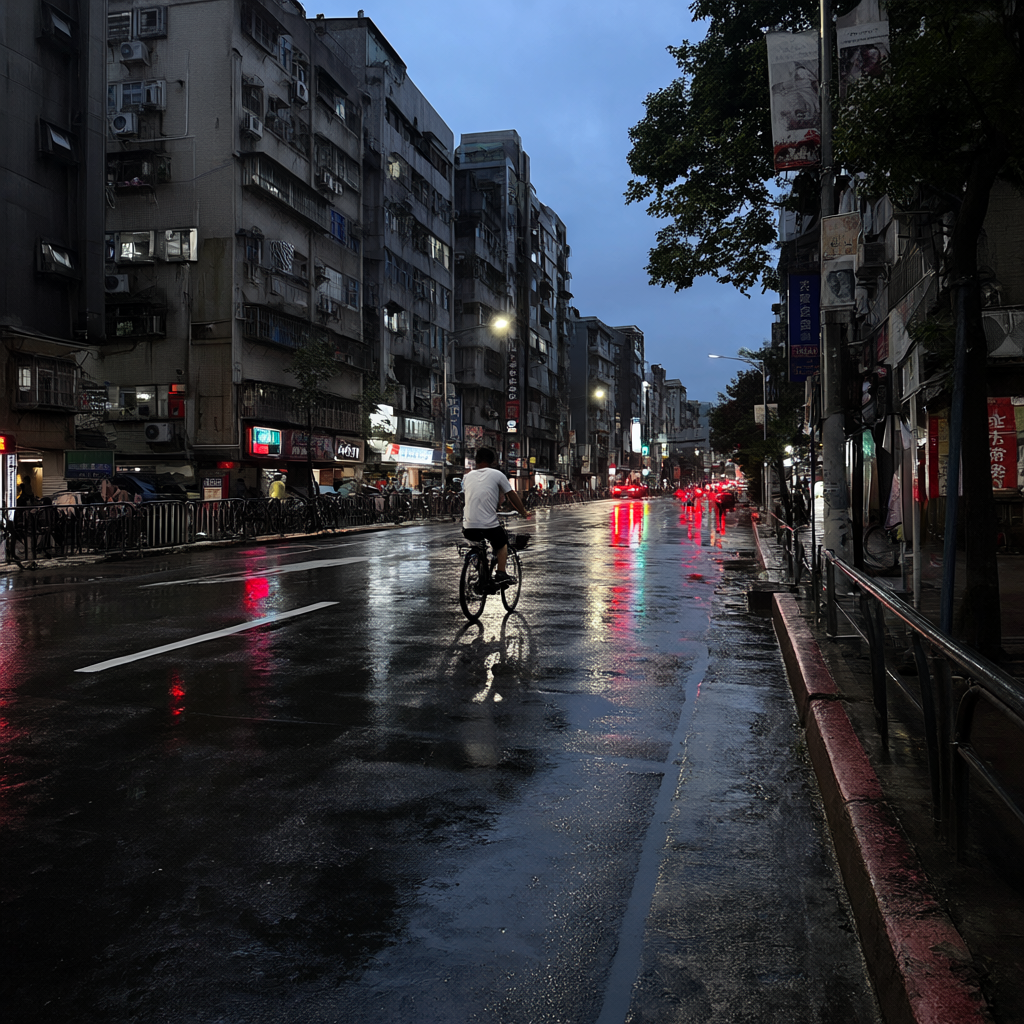
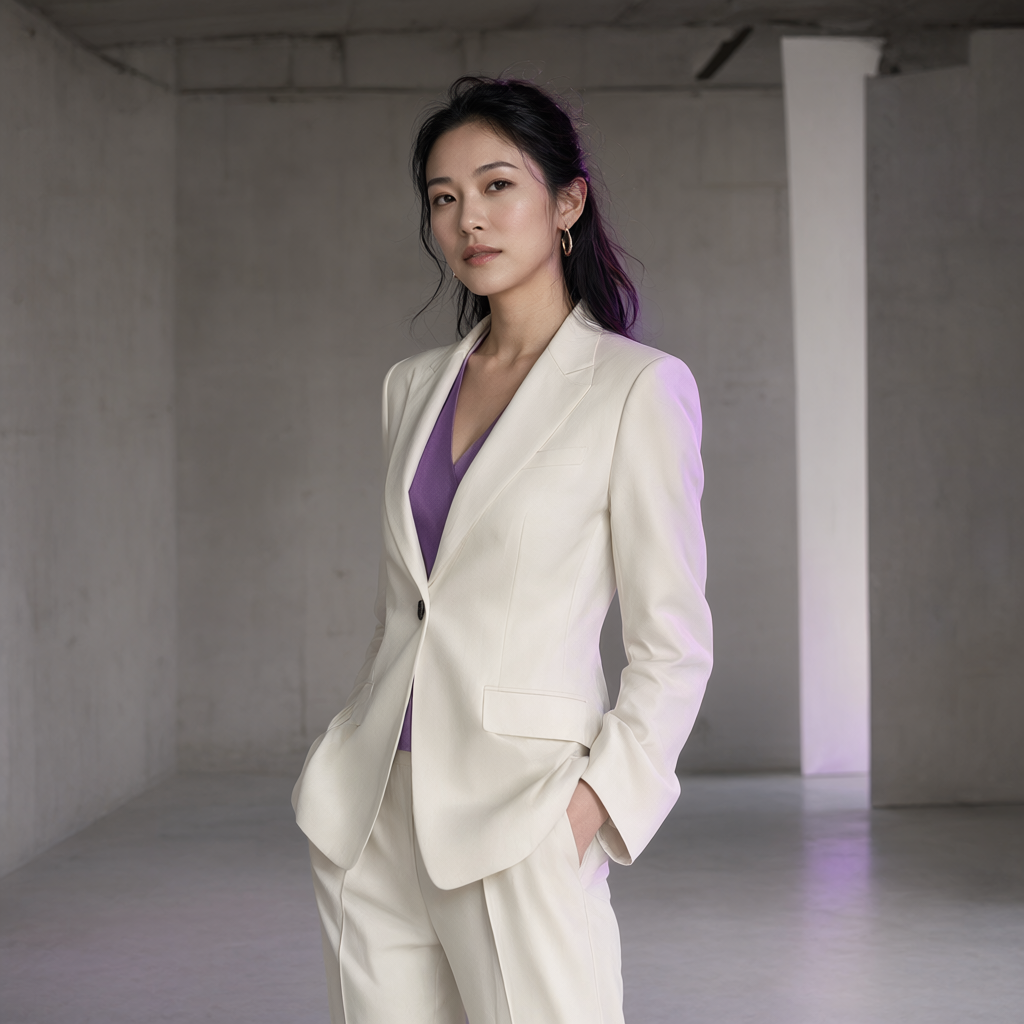
只是跑完上面那些測試後,我已經不會再把「prompt understanding 變好」當作 2.1 最主要的故事。
文字生圖是入口。真正有意思的是:你可以把結果繼續當素材使用。
官方還展示了什麼?哪些我這篇沒有假裝測過
Qwen 官方還展示了比我這次更多的 editing scenarios,包括:
- 最多 10 張 reference image
- painted annotation
- separate mask 指定局部修改
- 多人物合成
- virtual try-on,把人物、衣服、鞋、包、帽子一起組合
- 用多張家具 reference 重組室內空間
- 人像與商品 identity / fidelity preservation
- panorama
- 文字與排版生成
這些能力可以在官方 release 與 GitHub showcase 看到。
但我這篇只把我真的在 5060 Ti 上跑過的項目寫成「實測」:circle-guided local edit、兩張 reference、連續 edit、RGBA 生成、RGB → RGBA 主體抽取、Storyboard,以及 2048×2048 + typography。
其他項目等我真的跑過,再補結果。
ComfyUI 裡為什麼突然能做這麼多
從工作流角度來看,關鍵節點是新版的 TextEncodeQwenImage21。
它不只吃文字,也可以接受多張 reference image;這些圖片會同時進 Qwen3-VL text encoder,並在有 VAE 時轉成 reference latents 給 Qwen-Image-2.1。
我目前這套 ComfyUI 節點甚至暴露了最多 16 個 image slot;不過 Qwen 官方模型文件宣稱與測試的上限是 10 張,所以實際使用時我會以官方模型規格為準,而不是看到 UI 有 16 格就宣稱支援 16 張。
這也是我很喜歡這次架構的一點:模型本身不是把「文字」和「圖片」當成完全不同的入口,而是在同一個 conditioning 流程裡理解它們。
授權使用
目前 Qwen-Image-2.1 官方 repository 與模型頁標示的是 Qwen Research License Agreement,不是 Apache 2.0。
如果用途涉及產品、客戶專案或其他商業情境,我會直接以當下官方 LICENSE 原文為準,而不是只看社群貼文或模型名稱推論授權範圍。
模型、ComfyUI、第三方節點與最終輸出涉及的權利也不是同一件事,實際商用仍應分開確認。
結論:Qwen-Image-2.1 比較像本地 Photoshop AI layer,而不只是抽卡機
如果我只看最初那幾張 T2I 圖,我可能會把 Qwen-Image-2.1 總結成:畫面更漂亮、提示詞理解更好、可以原生 2K。
但這次在自己的 5060 Ti 上把 editing workflow 跑過一輪之後,我覺得這個描述太小了。
真正讓我在意的是下面這條鏈:
生成 → 參考多張圖片 → 指定局部修改 → 繼續修改上一張 → 抽透明圖層 → 做 Storyboard → 直接輸出 2K 成品。
這些事情開始可以留在同一個模型裡完成。
它還不是 Photoshop 的替代品,也不是角色一致性永遠不漂移的動畫模型。連續 edit 做到第三輪,我已經能看到 identity drift;多圖 reference 也不是 pixel-perfect asset copy。
但 Qwen-Image-2.1 已經讓本地 image model 從「幫我畫一張圖」往「幫我持續處理一組視覺素材」跨了一步。
對我來說,這才是 2.1 最值得寫的地方。